Frequent Itemset Mining e Association Rules
Il Modello del Carrello della Spesa (Market-Basket Model)
Il modello del carrello della spesa è un approccio fondamentale nell’analisi dei dati per identificare pattern di acquisto. Esso descrive una relazione molti-a-molti tra item (prodotti) e basket (transazioni o carrelli).
L’obiettivo è scoprire insiemi di articoli che vengono acquistati frequentemente insieme. Ogni carrello è considerato un insieme di articoli, senza tenere conto delle quantità. Questo modello è particolarmente rilevante in contesti con un numero elevato di transazioni e un numero relativamente piccolo di articoli per transazione.
Un esempio classico è l’analisi delle vendite di un supermercato, dove l’identificazione di prodotti spesso acquistati insieme (es. pannolini e birra) può guidare strategie di marketing e la disposizione dei prodotti.
Insiemi di Item Frequenti (Frequent Itemsets)
Un insieme di item (itemset) è un sottoinsieme di articoli. Un itemset è definito frequente se compare in un numero di transazioni pari o superiore a una soglia di supporto minima . Il supporto di un itemset è il numero di carrelli che contengono .
Consideriamo il seguente esempio con soglia di supporto :
| Carrello ID | Contenuto |
|---|---|
| B1 | {latte, coca, birra} |
| B2 | {latte, pepsi, succo} |
| B3 | {latte, birra} |
| B4 | {coca, succo} |
| B5 | {latte, pepsi, birra} |
| B6 | {latte, coca, birra, succo} |
| B7 | {coca, birra, succo} |
| B8 | {birra, coca} |
Calcolo del supporto:
- Il supporto di
{latte}è 5. - Il supporto di
{birra}è 6. - Il supporto di
{latte, birra}è 3. - Il supporto di
{coca, succo}è 3. - Il supporto di
{latte, coca, birra}è 2.
Risultato: con gli itemset frequenti includono {latte}, {coca}, {birra}, {succo}, {latte, birra}, {coca, succo}.
Applicazioni degli insiemi di item frequenti:
- Market basket: ottimizzazione del layout dei negozi e delle promozioni.
- Concetti correlati: analisi di documenti per scoprire concetti congiunti.
- Plagio: identificazione di documenti con frasi comuni.
Regole di Associazione (Association Rules)
L’identificazione degli itemset frequenti è il prerequisito per la scoperta delle regole di associazione, che esprimono dipendenze del tipo “if-then”.
Una regola ha la forma , dove:
- è l’antecedente (un itemset);
- è il conseguente (un singolo item).
Questa regola indica che se tutti gli item in sono presenti in un carrello, è probabile che anche lo sia.
Metriche di valutazione
Per valutare la significatività di una regola si utilizzano due metriche principali.
1. Supporto: la frazione di transazioni che contengono sia l’antecedente sia il conseguente . Corrisponde al supporto dell’itemset .
2. Confidenza: misura la probabilità che sia presente in un carrello, dato che è già presente.
La confidenza è un valore tra 0 e 1. Una confidenza elevata indica una forte dipendenza. Tuttavia, non tutte le regole con alta confidenza sono interessanti.
La regola può avere una confidenza elevata per molti insiemi , poiché il latte è acquistato molto spesso (indipendentemente da ): la confidenza risulta alta ma poco informativa.
3. Interesse (Lift): per ovviare ai limiti della confidenza si può considerare l’interesse, che confronta la confidenza della regola con la probabilità attesa di se gli item fossero indipendenti:
Un interesse positivo suggerisce che e appaiono insieme più frequentemente di quanto ci si aspetterebbe per caso.
Processo di scoperta delle regole
Si articola in due fasi:
- Individuazione degli insiemi frequenti: trovare tutti gli itemset che soddisfano una soglia di supporto minima .
- Generazione delle regole di associazione: da ogni itemset frequente si generano regole del tipo e se ne calcola la confidenza, scartando quelle al di sotto di una soglia minima .
Gestione della Memoria nel Conteggio di Coppie
Nella Market Basket Analysis il collo di bottiglia è spesso la memoria RAM necessaria a contare le coppie di item. Esistono due strategie principali per ottimizzare questo spazio.
1. Metodo della Matrice Triangolare (Triangular Matrix Method)
Questo metodo è ideale quando i dati sono densi (molte coppie diverse appaiono nei carrelli).
- Rappresentazione degli item: per massimizzare l’efficienza, gli item vengono mappati come interi consecutivi da a utilizzando una tabella hash.
- Logica di memorizzazione: si conta ogni coppia una sola volta assicurando che . Invece di usare una matrice quadrata (dove metà spazio sarebbe sprecato e la diagonale inutile), si utilizza un array monodimensionale che simula una matrice triangolare.
- Formula di indicizzazione: il conteggio della coppia si trova nell’array alla posizione :
- Ordine lessicografico: le coppie vengono salvate seguendo l’ordine
2. Metodo delle Triple (Triples Method)
Questo metodo è preferibile quando i dati sono sparsi (poche coppie uniche rispetto a quelle possibili).
- Struttura: i conteggi sono memorizzati come triple , dove:
- : indici degli item (con );
- : conteggio della frequenza della coppia.
- Supporto: si utilizza una tabella hash con chiave per individuare rapidamente la tripla corrispondente.
- Efficienza di spazio: non viene occupato spazio per le coppie con conteggio pari a zero. Tuttavia, ogni coppia esistente richiede lo spazio di 3 interi più l’overhead della tabella hash.
Confronto e scelta del metodo
La scelta dipende dalla densità delle coppie nel dataset:
| Metodo | Quando conviene | Costo per coppia |
|---|---|---|
| Matrice triangolare | Se almeno 1/3 delle coppie possibili compare in almeno un carrello | 1 intero per ogni coppia possibile |
| Triple | Se compare molto meno di 1/3 delle coppie possibili | 3 interi (+ overhead hash) solo per le coppie presenti |
Proprietà di Monotonicità degli Itemset
La ricerca degli itemset frequenti si basa su un principio logico chiamato Proprietà di Monotonicità (o Principio di A-Priori):
Se un insieme di item è frequente, allora ogni suo sottoinsieme è anch’esso frequente.
Esempio: se appare in 100 carrelli, allora anche apparirà in almeno 100 carrelli.
Itemset Massimali
Dato un supporto minimo , un itemset è detto massimale se è frequente, ma nessuno dei suoi sovrainsiemi lo è.
Conoscere gli itemset massimali è estremamente potente perché:
- Sottoinsiemi: sappiamo automaticamente che tutti i loro sottoinsiemi sono frequenti.
- Esclusione: sappiamo che nessun insieme che non sia sottoinsieme di un itemset massimale può essere frequente.
Questa proprietà è fondamentale perché permette all’algoritmo di potare (pruning) lo spazio di ricerca, evitando di contare combinazioni di item che non hanno alcuna possibilità di essere frequenti.
Vediamo ora gli algoritmi per l’individuazione degli insiemi frequenti.
L’Algoritmo A-Priori
L’Algoritmo A-Priori è progettato per ridurre il numero di coppie (e di -ple) da contare, ottimizzando l’uso della memoria RAM al costo di effettuare più passaggi sui dati.
1. Primo passaggio (First Pass)
In questa fase l’obiettivo è identificare quali singoli item sono promettenti.
- Tabella di traduzione: converte i nomi degli item in interi .
- Tabella dei conteggi: un array monodimensionale dove l’elemento registra quante volte l’item appare in tutti i carrelli.
2. Tra il primo e il secondo passaggio
Si effettua il “filtro” basato sulla soglia di supporto (es. 1% dei carrelli).
- Singleton frequenti (): si isolano gli item il cui conteggio è .
- Frequent-Items Table: si crea un nuovo array di dimensione .
- Se l’item non è frequente valore 0.
- Se l’item è frequente gli viene assegnato un nuovo indice univoco da a (dove ).
3. Secondo passaggio (Second Pass)
Qui si contano solo le coppie “potenzialmente” frequenti.
- Generazione coppie: per ogni carrello si considerano solo gli item che nella tabella precedente hanno un indice , e si generano tutte le possibili coppie tra questi item frequenti.
- Incremento: si aggiorna la struttura dati (matrice triangolare o triple) usando i nuovi indici .
- Risultato: si ottiene , l’insieme delle coppie frequenti.
Osservazioni sulla memoria:
- Usando la matrice triangolare, lo spazio scende da a byte.
- Se solo il 50% degli item è frequente (), lo spazio richiesto si riduce a 1/4 dell’originale.
A-Priori per insiemi di dimensione
L’algoritmo sfrutta la proprietà di monotonicità: un insieme di dimensione può essere frequente solo se tutti i suoi sottoinsiemi di dimensione lo sono.
L’algoritmo alterna fasi di generazione dei candidati e fasi di conteggio:
- (Candidati): insieme degli itemset di dimensione che potrebbero essere frequenti (costruiti a partire da ).
- (Frequenti): insieme degli itemset di dimensione che, dopo il conteggio sul dataset, superano effettivamente la soglia .
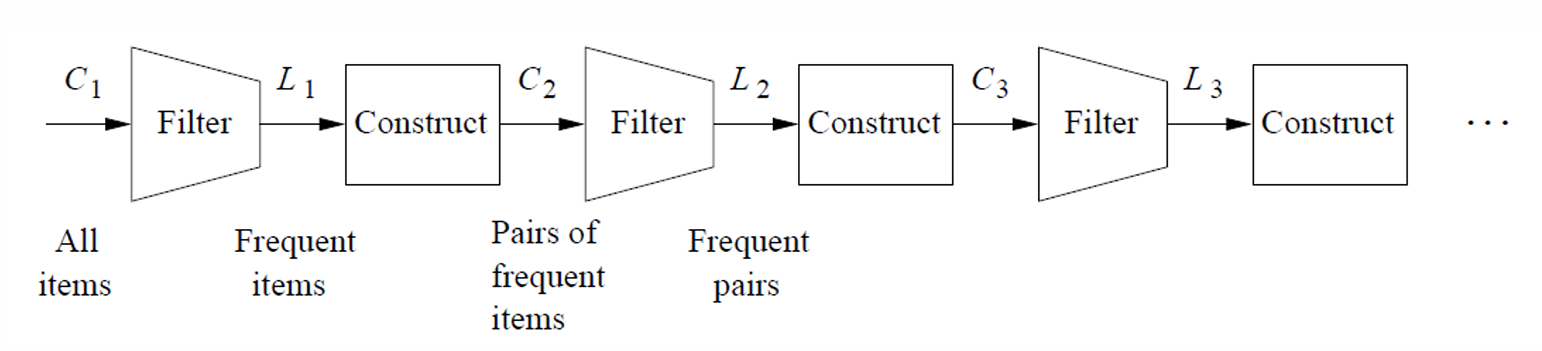
Passaggi ipotetici dell’algoritmo A-Priori:
- Calcolare il supporto degli insiemi di elementi in .
- Eliminare quelli non frequenti: .
- Generare .
- Calcolare il supporto degli insiemi di elementi in .
- Eliminare quelli non frequenti: .
- Generare .
- Calcolare il supporto degli insiemi di elementi in .
- Eliminare quelli non frequenti: .
Gestione di grandi dataset e limiti
L’efficacia di A-Priori dipende dalla RAM disponibile:
- Capacità: il passaggio con il maggior numero di candidati (solitamente ) deve risiedere interamente in memoria.
- Thrashing: se la RAM non è sufficiente, il sistema inizia a spostare dati continuamente tra RAM e disco rigido. Questo fenomeno, detto thrashing, rallenta drasticamente l’esecuzione, rendendo l’algoritmo inefficiente.
Seguono alcune possibili ottimizzazioni.
L’Algoritmo di Park, Chen e Yu (PCY)
L’algoritmo PCY è un’estensione dell’A-Priori che sfrutta la memoria principale inutilizzata durante il primo passaggio per ridurre drasticamente il numero di coppie candidate da analizzare nel secondo passaggio.
flowchart LR
    A["Pass 1: conta singoli item + hash di tutte le coppie nei bucket"] --> B["Tra i pass: L1 + bitmap dei bucket frequenti"]
    B --> C["Pass 2: conta {i,j} solo se i, j frequenti e bucket frequente"]
    C --> D["L2: coppie frequenti"]
1. Primo passaggio (First Pass)
Mentre l’A-Priori conta solo i singoli item, il PCY utilizza lo spazio rimanente in RAM per creare una hash table di “bucket” (secchielli).
Operazioni per ogni carrello:
- Conteggio item singoli: per ogni item nel carrello si incrementa il relativo contatore nell’array dei singleton.
- Generazione di TUTTE le coppie: tramite un doppio ciclo si generano tutte le possibili coppie contenute nel carrello (indipendentemente dal fatto che gli item siano frequenti o meno).
- Hashing delle coppie: ogni coppia viene passata a una funzione di hash e si incrementa di 1 il contatore del bucket corrispondente.
- Esempio di funzione di hash:
- L’output sarà un indice nell’intervallo .
Nota tecnica:
- La coppia in sé non viene memorizzata nel bucket; si salva solo il contatore incrementato.
- Collisioni: coppie diverse possono finire nello stesso bucket.
2. Tra il primo e il secondo passaggio
Alla fine del primo passaggio ogni bucket ha un conteggio totale.
- Bucket frequente: un bucket il cui conteggio è (soglia di supporto).
- Filtro fondamentale: se un bucket è infrequente, allora nessuna coppia al suo interno può essere frequente.
- Bitmap: la tabella di hash viene riassunta in una bitmap (vettore di bit):
- Bit = 1: bucket frequente.
- Bit = 0: bucket infrequente.
- Vantaggio: riduce l’occupazione di memoria a rispetto all’uso di interi a 32 bit.
3. Secondo passaggio (Second Pass)
Il set di coppie candidate è molto più ristretto rispetto all’A-Priori. Una coppia viene contata solo se soddisfa due condizioni:
- Entrambi gli item e sono frequenti (come in A-Priori).
- La coppia viene mappata in un bucket che la bitmap indica come frequente (condizione distintiva di PCY).
Limiti strutturali e scelta del metodo
A differenza di A-Priori, nel PCY non è possibile usare il metodo della matrice triangolare per il conteggio nel secondo passaggio.
- Motivo: le coppie rimosse dal PCY sono distribuite casualmente. Non esiste un modo per “compattare” la matrice eliminando i buchi lasciati dalle coppie scartate.
- Conseguenza: nel PCY si è costretti a utilizzare il metodo delle triple.
Evitare gli Errori nei Metodi di Campionamento
Tipi di errori possibili
- Falso negativo: un itemset che è frequente nel dataset completo ma non risulta frequente nel campione.
- Falso positivo: un itemset che risulta frequente nel campione ma non lo è nel dataset completo.
Gli itemset con un supporto molto vicino alla soglia hanno probabilità simili di risultare frequenti o meno nel campione.
Correzione dei falsi positivi
Per eliminare i falsi positivi si può eseguire un passaggio completo sull’intero dataset, contando solo gli itemset che erano stati trovati frequenti nel campione. Questo processo rimuove tutti i falsi positivi, ma i falsi negativi rimangono, poiché non vengono contati.
Riduzione dei falsi negativi
Se la memoria lo consente, è possibile ridurre i falsi negativi abbassando la soglia di supporto nel campione.
Se è la soglia di supporto del dataset e il campione rappresenta una frazione del dataset intero, si può usare come soglia per il campione, oppure un valore leggermente inferiore, ad esempio .
Abbassare la soglia comporta l’aumento del numero di itemset da conteggiare, e quindi maggiori esigenze di memoria.
Algoritmo SON (Savasere-Omiecinski-Navathe)
Obiettivo: gestire dataset troppo grandi per la memoria RAM sfruttando il partizionamento. È l’algoritmo ideale per ambienti distribuiti (es. MapReduce).
Principio fondamentale: se un itemset è frequente nell’intero dataset, allora deve essere frequente in almeno una delle partizioni (chunk).
Funzionamento (two-pass):
- Passaggio 1 (locale): il dataset viene diviso in partizioni. Si esegue A-Priori (o un altro algoritmo) su ogni partizione singolarmente, usando una soglia di supporto scalata (). L’unione di tutti gli itemset trovati frequenti localmente diventa l’elenco dei Candidati Globali.
- Passaggio 2 (globale): si scansiona l’intero dataset un’ultima volta per contare il supporto reale solo dei Candidati Globali identificati nel passo 1.
- Risultato: vengono restituiti solo gli itemset che superano la soglia di supporto globale .
Vantaggio: non genera falsi negativi (garantito dalla matematica) e richiede solo due passaggi completi sui dati.
Algoritmo di Toivonen
Obiettivo: ridurre drasticamente il numero di passaggi sul dataset completo (spesso ne basta 1) utilizzando un campionamento casuale.
Funzionamento:
- Campionamento: si estrae un piccolo campione casuale dal dataset.
- Soglia abbassata: si cercano gli itemset frequenti nel campione, ma usando una soglia di supporto leggermente più bassa (es. ) per aumentare la probabilità di catturare i “veri” frequenti.
- Frontiera negativa (negative border): si costruisce la frontiera negativa, ovvero l’insieme degli itemset che non sono frequenti nel campione, ma i cui sottoinsiemi immediati lo sono tutti.
- Validazione: si scansiona il dataset completo contando sia i frequenti trovati nel campione sia quelli della frontiera negativa.
flowchart TD
    A["Campione casuale"] --> B["Itemset frequenti nel campione (soglia ridotta, es. 0.8 s)"]
    B --> C["Costruzione della frontiera negativa"]
    C --> D["Pass completo: conta frequenti + frontiera negativa"]
    D --> E{"Qualche itemset della frontiera è frequente?"}
    E -- "No" --> F["Output: itemset frequenti esatti"]
    E -- "Sì" --> G["Fallimento: ripetere con nuovo campione"]
Gestione degli errori:
- Nessun falso positivo: poiché si fa un conteggio finale sul dataset completo, i falsi positivi vengono scartati.
- Rischio falsi negativi: se un itemset è frequente nel dataset completo ma non è stato trovato nel campione e non è nemmeno nella frontiera negativa, l’algoritmo fallisce. In questo caso (raro se il campione è buono) l’algoritmo deve essere rieseguito con un nuovo campione.
Confronto tra gli algoritmi
| Algoritmo | Idea chiave | Passaggi sul dataset | Falsi positivi / negativi |
|---|---|---|---|
| A-Priori | Monotonicità, | (uno per dimensione) | Esatto |
| PCY | Hash delle coppie + bitmap nel pass 1 | Come A-Priori, ma più piccolo | Esatto |
| SON | Partizionamento in chunk, soglia | 2 | Nessun FN, FP rimossi nel pass 2 |
| Toivonen | Campione + frontiera negativa | Spesso 1 | Nessun FP; FN rilevati → si ripete |
Il Problema della Ricerca di Documenti Simili
Nel contesto dei Big Data, l’identificazione di documenti simili all’interno di collezioni di vaste dimensioni rappresenta una sfida significativa. Confrontare ogni documento con ogni altro per determinarne la similarità è un’operazione computazionalmente proibitiva.
Ad esempio, per milione di documenti, il numero di confronti necessari sarebbe di circa , richiedendo tempi di calcolo eccessivi.
Questo problema emerge in diverse applicazioni cruciali:
- Identificazione di contenuti duplicati: rilevamento di siti mirror o quasi-duplicati per ottimizzare i risultati dei motori di ricerca.
- Raggruppamento di informazioni: aggregazione di articoli di notizie che trattano lo stesso evento da fonti diverse.
- Rilevamento di plagio: individuazione di testi copiati o riutilizzati in ambito accademico o professionale.
- Sistemi di raccomandazione: suggerimento di contenuti affini agli interessi dell’utente.
Per superare l’inefficienza del confronto diretto sono state sviluppate tecniche che riducono la dimensionalità dei dati e permettono di focalizzarsi solo sulle coppie di documenti più promettenti.
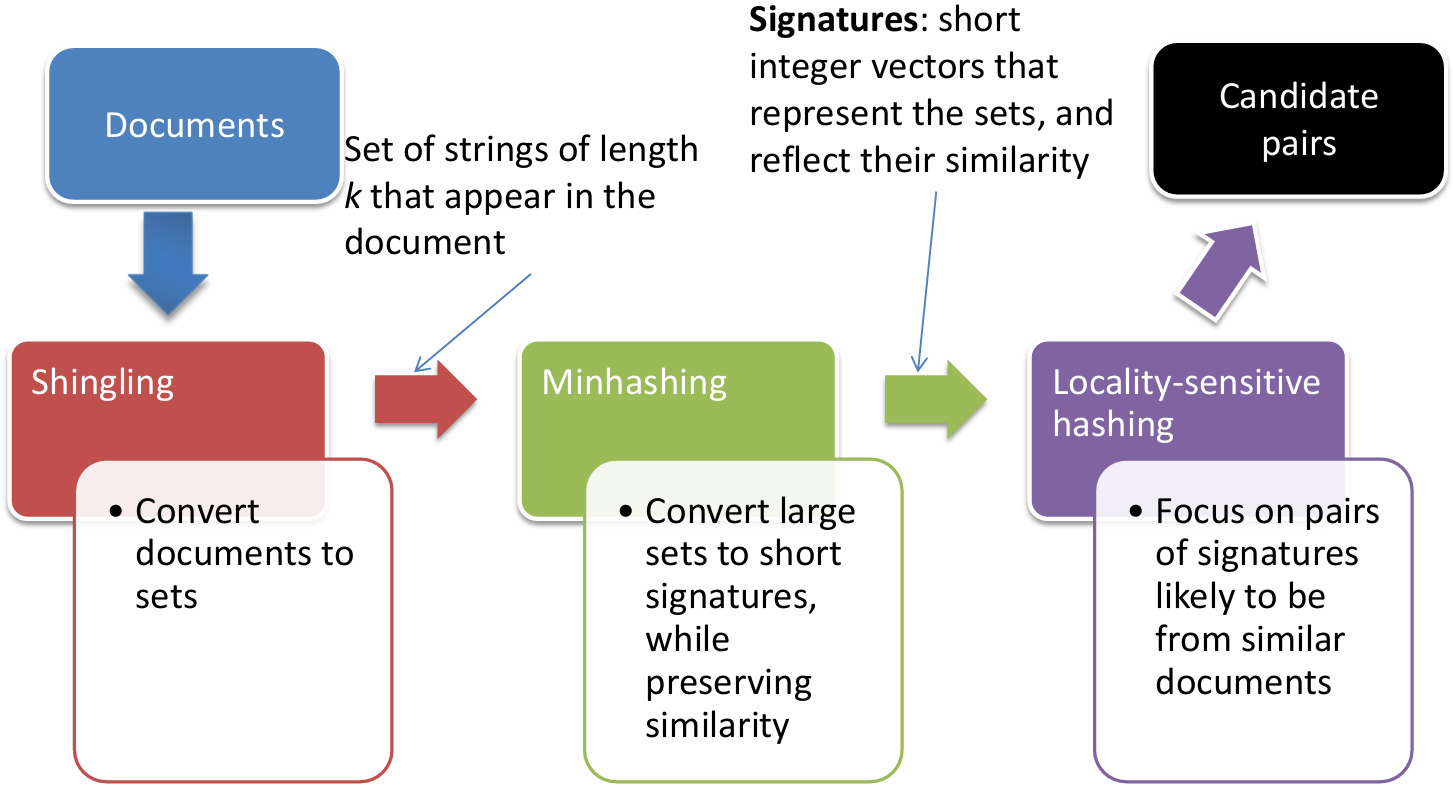
Shingling: Rappresentare i Documenti come Insiemi
Lo shingling è una tecnica fondamentale per trasformare un documento testuale in un formato che ne catturi il contenuto in modo efficace e confrontabile. Converte un documento in un insieme di brevi stringhe, denominate shingles o n-grammi.
Cosa sono gli shingles?
Un k-shingle è definito come ogni sottostringa di lunghezza presente in un documento. Associando a ciascun documento l’insieme dei -shingles che vi appaiono, il documento viene rappresentato come un insieme di queste unità. È comune normalizzare il testo trattando sequenze di spazi bianchi come un singolo spazio.
Per il documento e , l’insieme dei 2-shingles è . Le ripetizioni sono generalmente ignorate per la maggior parte delle applicazioni di similarità.
Scelta della dimensione dello shingle ()
La scelta del valore di è critica:
- Se è troppo piccolo, molti shingles appariranno in quasi tutti i documenti, rendendo la similarità poco discriminante.
- Se è troppo grande, ogni shingle potrebbe essere unico per un solo documento, annullando la similarità.
Un criterio generale suggerisce di scegliere sufficientemente grande da rendere bassa la probabilità che uno shingle appaia casualmente in documenti diversi:
- per documenti di medie dimensioni (es. email), è spesso adeguato;
- per documenti più lunghi (es. articoli scientifici), è considerato più sicuro.
1. Trasformazione del documento in shingles
- Estrazione: si divide il documento in shingles (es. ).
- Mapping: si applica una funzione di hash a ogni shingle:
- Rappresentazione: il documento ora non è più un insieme di stringhe, ma un insieme di numeri interi.
Nota sulle collisioni: è possibile che due shingle diversi finiscano nello stesso numero (collisione), ma con una funzione di hash a 64 bit la probabilità è così bassa da essere trascurabile per scopi pratici.
2. La matrice caratteristica
Una volta ottenuti gli shingles hashati, possiamo immaginare i dati come una gigantesca matrice:
- Righe: rappresentano tutti i possibili valori di hash (l’unione di tutti gli shingles di tutti i documenti).
- Colonne: rappresentano i documenti.
- Valore: 1 se il documento contiene lo shingle , altrimenti 0.
Poiché il numero di possibili shingles è enorme, questa matrice è estremamente sparsa (piena di zeri). Non la memorizziamo mai interamente, ma è il concetto matematico su cui si basa il calcolo della somiglianza.
Rappresentazione e similarità di Jaccard
Una volta generati gli shingles, i documenti possono essere rappresentati come vettori binari (0/1) in uno spazio multidimensionale, dove ogni dimensione corrisponde a uno shingle unico nella collezione.
La similarità tra due documenti e può essere misurata tramite la similarità di Jaccard tra i loro insiemi di shingles e :
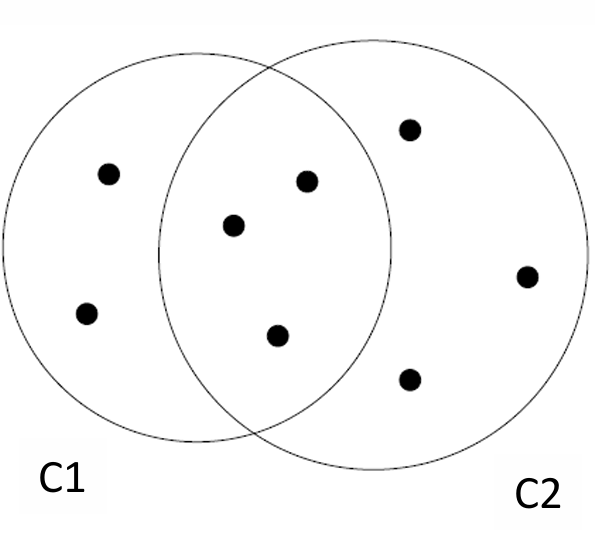
Questa rappresentazione, sebbene porti a matrici molto grandi e sparse, è il punto di partenza per tecniche più avanzate.
Minhashing: Creare Signature Compatte
Il calcolo diretto della similarità di Jaccard per tutte le coppie di documenti basato sulla matrice di shingles rimane computazionalmente oneroso. Il Minhashing risolve questo problema creando signature compatte per ciascun documento, che preservano la similarità di Jaccard degli insiemi di shingles originali.
L’idea chiave: permutazioni e valori minimi
Il Minhashing si basa sul principio che la probabilità che due insiemi abbiano lo stesso valore minimo sotto una permutazione casuale delle righe della matrice di shingles è uguale alla loro similarità di Jaccard.
In pratica si utilizzano diverse funzioni di hash per simulare permutazioni casuali delle righe. Per ogni documento si calcola un vettore di valori minimi, chiamato signature. Se si usano funzioni di hash, la signature di un documento sarà un vettore di numeri interi. La similarità tra due documenti è quindi stimata dalla frazione di funzioni di hash per cui i valori minimi corrispondenti nelle loro signature sono uguali.
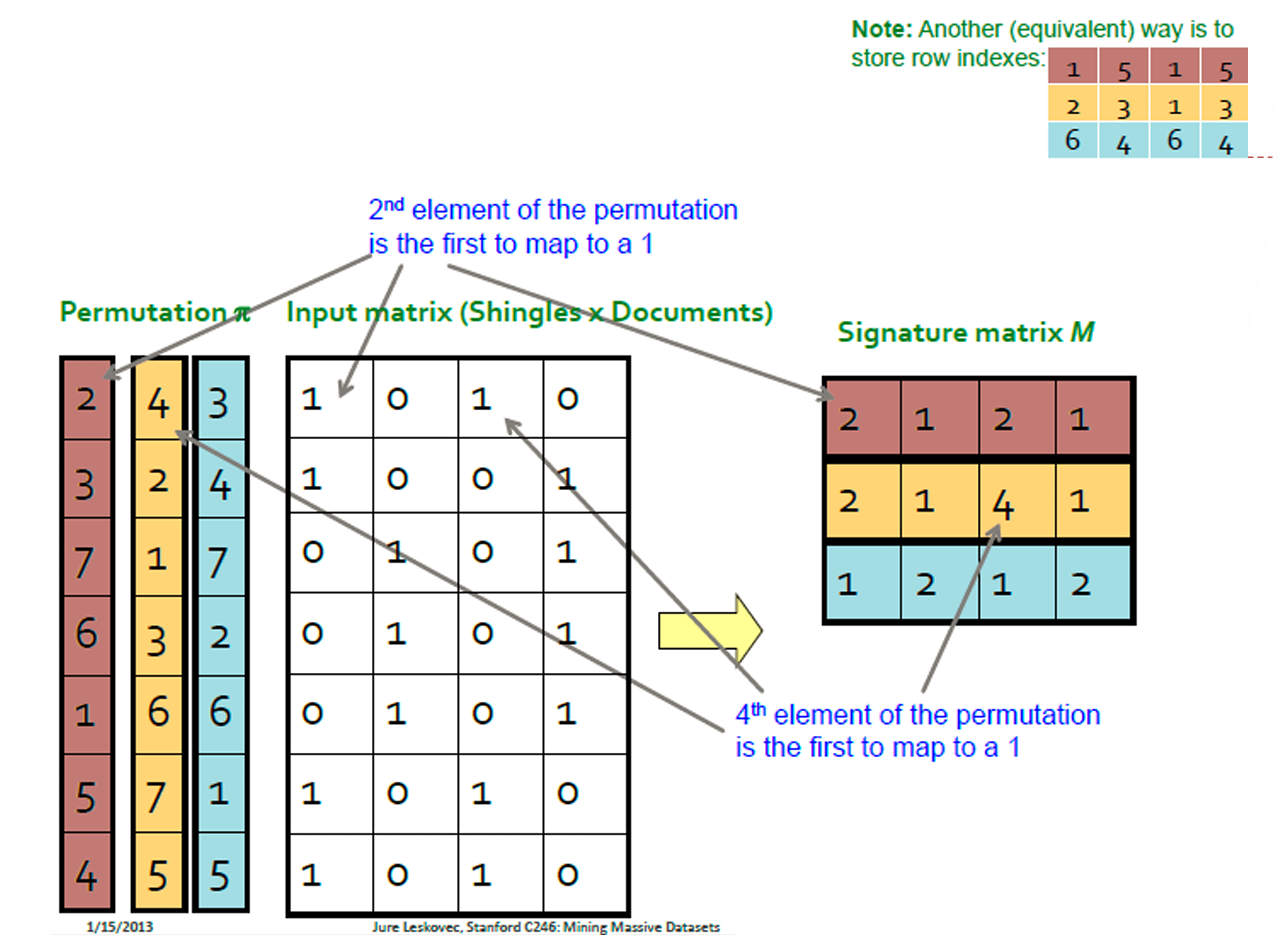
Nella matrice caratteristica le righe sono gli ID degli shingles hashati. L’algoritmo si chiede: “E se mescolassimo l’ordine delle righe in modo casuale?”. Questa è la permutazione.
Per ogni colonna (documento) e per ogni permutazione effettuata:
- Scorri le righe della matrice partendo dall’alto (nel nuovo ordine dato dalla permutazione).
- Fermati appena incontri il primo “1”.
- Segnati il numero della riga (o l’indice) in cui hai trovato quell’1.
Questo numero è il MinHash del documento per quella specifica permutazione.
Un solo MinHash non basta a descrivere un documento. Per creare una signature robusta:
- si scelgono permutazioni diverse (solitamente tra 100 e 500);
- per ogni permutazione si annota l’indice del primo 1;
- alla fine, ogni documento sarà rappresentato da un vettore di numeri (la signature).
Risultato: abbiamo trasformato una colonna di milioni di bit in un piccolo vettore di (ad esempio) 200 numeri interi.
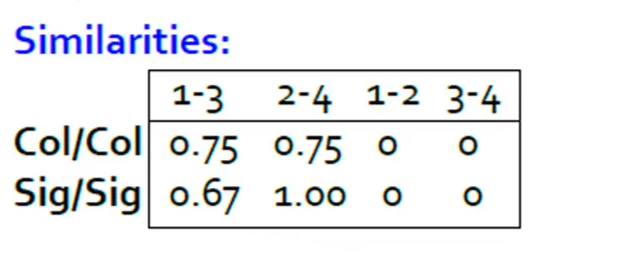
Date le signature e (ottenute con 4 funzioni di hash), le posizioni coincidenti sono la prima e la terza. La similarità stimata è .
La ragione per cui facciamo tutto questo è un teorema matematico:
La probabilità che due documenti abbiano lo stesso valore di MinHash per una permutazione casuale è esattamente uguale alla loro similarità di Jaccard:
Quindi:
- se due documenti sono identici (Jaccard = 1), avranno sempre il “primo 1” nella stessa riga, quindi signature identiche;
- se sono simili al 50%, avranno lo stesso numero nella signature circa il 50% delle volte.
Implementazione con funzioni di hash
Permutare fisicamente una matrice con milioni di righe è impossibile per un computer. In pratica, invece di “mescolare le righe”, si usano delle funzioni di hash:
- per ogni riga che contiene un “1” per il documento ;
- si calcolano (dove ogni simula una permutazione);
- per ogni funzione di hash si tiene solo il valore minimo trovato tra tutte le righe con “1” — ecco perché si chiama MinHashing!
Vantaggi del Minhashing
- Riduzione della dimensionalità: le signature sono significativamente più piccole degli insiemi di shingles originali.
- Preservazione della similarità: la similarità tra le signature è una buona stima della similarità di Jaccard.
- Efficienza: il confronto delle signature è molto più rapido rispetto al confronto degli insiemi di shingles.
Accelerazione e precisione
Per velocizzare si possono analizzare solo le prime righe su . Se una colonna ha solo zeri nelle prime righe, il suo valore è .
- Confronto con : se entrambe hanno , la riga non conta; se una sola ha , conta come differenza.
- Questo riduce il lavoro di un fattore , permettendo di usare più funzioni di hash per compensare la leggera perdita di precisione.
Locality-Sensitive Hashing (LSH) per la Ricerca di Coppie Simili
Anche con le signature MinHash, confrontare tutte le coppie di documenti può essere troppo lento per collezioni estremamente grandi. Il Locality-Sensitive Hashing (LSH) aggira questo problema raggruppando documenti potenzialmente simili in “bucket”, riducendo drasticamente il numero di confronti necessari.
L’idea generale di LSH
LSH impiega funzioni di hash con la proprietà di “località sensibile”: elementi simili hanno un’alta probabilità di finire nello stesso bucket, mentre elementi dissimili hanno un’alta probabilità di finire in bucket diversi.
Nel contesto del Minhashing, LSH divide la matrice delle signature in diverse “bande” (gruppi di righe). Ogni banda viene poi hashata in un numero di bucket. Due documenti sono considerati una “coppia candidata” se le loro signature corrispondenti finiscono nello stesso bucket per almeno una banda.
Partizionare la matrice delle signature in bande
Data una matrice di signature con righe (corrispondenti al numero di funzioni di hash) e colonne (documenti):
- Divisione in bande: la matrice viene suddivisa in bande, ciascuna contenente righe, tale che .
- Hashing delle bande: per ogni banda si applica una funzione di hash alle righe che la compongono per ciascuna colonna. Le colonne che producono lo stesso valore hash per una data banda sono considerate coppie candidate.
- Identificazione delle coppie candidate: due documenti diventano una coppia candidata se le loro signature corrispondenti sono identiche in almeno una banda.
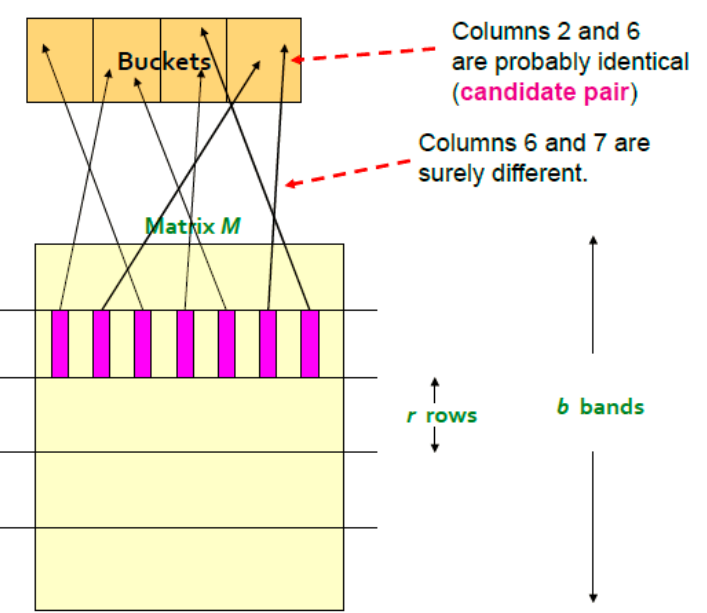
La scelta dei parametri (numero di bande) e (righe per banda) è cruciale per bilanciare i falsi positivi (coppie dissimili erroneamente considerate simili) e i falsi negativi (coppie simili non identificate).
Analisi della tecnica delle bande
La probabilità che due documenti con similarità di Jaccard diventino una coppia candidata è data da:
- : probabilità che tutte le righe di una banda siano uguali;
- : probabilità che almeno una riga di una banda sia diversa;
- : probabilità che nessuna banda sia identica.
Soglia (threshold): il punto critico è circa
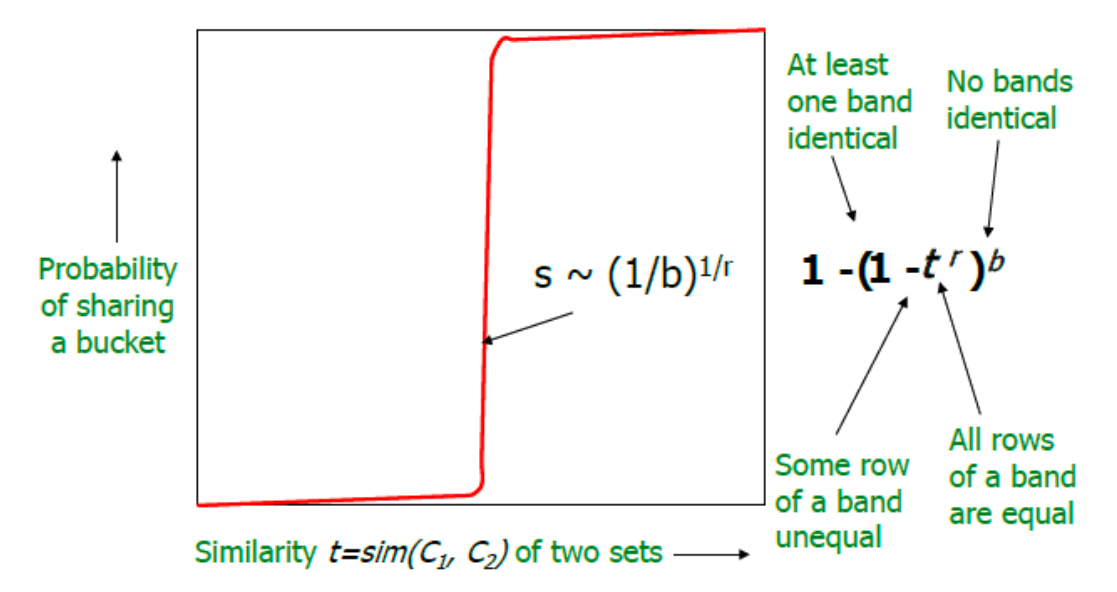
Questa funzione ha una forma a “S”: la probabilità di candidarsi è bassa per basse e alta per alte. I parametri e determinano la “ripidità” di questa curva e la soglia di similarità attorno alla quale la probabilità di candidarsi cresce rapidamente.
Tuning:
- Più bande (): meno falsi negativi (trovi tutto), ma più falsi positivi.
- Più righe (): filtro più stretto (solo documenti molto simili).
Vantaggi di LSH
- Scalabilità: riduce drasticamente il numero di confronti necessari, rendendo possibile l’analisi di collezioni di documenti molto grandi.
- Efficienza: focalizza l’attenzione solo sulle coppie di documenti che hanno una probabilità significativa di essere simili.
In sintesi, lo Shingling trasforma i documenti in insiemi gestibili, il Minhashing crea rappresentazioni compatte (signature) che preservano la similarità di Jaccard, e LSH utilizza queste signature per identificare efficientemente coppie di documenti potenzialmente simili, evitando confronti esaustivi. Queste tecniche sono essenziali per la gestione e l’analisi di grandi volumi di dati testuali.
Schema riassuntivo del processo combinato
- Shingling: estrai i -shingles da ogni documento.
- MinHash: calcola le signature di lunghezza usando funzioni di hash minimizzate.
- LSH: definisci la soglia e scegli tali che .
- Filtro candidati: applica LSH per trovare solo le coppie sospette.
- Verifica: confronta le signature delle coppie candidate.
- (Opzionale): se le signature confermano la similarità, verifica i documenti originali.
Bag of Words (BoW)
Un altro metodo di tokenizzazione, oltre agli shingles, è il Bag of Words.
Immagina di prendere un documento, ritagliare ogni singola parola e buttarla dentro un sacchetto (un “bag”, appunto). In questo sacchetto perdi l’ordine delle parole e la struttura grammaticale, ma mantieni la frequenza di ogni parola. Dunque la BoW è una rappresentazione testuale che ignora l’ordine delle parole e considera solo la loro frequenza nel testo.
Il processo:
- Vocabolario: si crea un elenco di tutte le parole uniche presenti nel set di documenti (es. “il”, “gatto”, “corre”, “topo”).
- Vettorizzazione: ogni documento viene trasformato in un vettore dove ogni posizione corrisponde a una parola del vocabolario. Il valore in quella posizione indica quante volte la parola appare nel documento.
- Doc 1: “Il gatto mangia il topo”
- Doc 2: “Il topo mangia il formaggio”
- Vocabolario:
{il, gatto, mangia, topo, formaggio} - Vettore Doc 1: (la parola “il” appare 2 volte, “formaggio” 0).
Il Bag of Words è un metodo usato nei modelli di recupero dell’informazione (information retrieval).
Riepilogo
| Concetto | Descrizione |
|---|---|
| Market-basket model | Relazione molti-a-molti tra item e basket; si cercano item acquistati insieme, ignorando le quantità |
| Supporto | Numero (o frazione) di carrelli che contengono l’itemset ; frequente se |
| Regola di associazione | ; supporto |
| Confidenza | , tra 0 e 1 |
| Interesse (Lift) | ; positivo = più frequente del caso |
| Matrice triangolare | Array 1D, ; conviene se almeno 1/3 delle coppie compare |
| Metodo delle triple | solo per coppie presenti (3 interi + hash); conviene con dati sparsi |
| Monotonicità | Se è frequente, ogni suo sottoinsieme lo è; consente il pruning |
| Itemset massimale | Frequente, ma nessun sovrainsieme lo è |
| A-Priori | Alterna (candidati) e (frequenti); un passaggio per dimensione; memoria da a byte |
| PCY | Pass 1: hash di tutte le coppie in bucket → bitmap; pass 2 conta solo coppie con item frequenti e bucket frequente; richiede le triple |
| Campionamento | Falsi positivi rimossi con un pass completo; falsi negativi ridotti con soglia (o ) |
| SON | partizioni con soglia → candidati globali → conteggio reale; 2 passaggi, nessun falso negativo |
| Toivonen | Campione con soglia ridotta + frontiera negativa; spesso 1 pass; se un elemento della frontiera è frequente si ripete |
| k-shingle | Sottostringa di lunghezza ; per email, per documenti lunghi |
| Similarità di Jaccard | |
| MinHash | Indice del primo 1 sotto una permutazione; |
| Signature | Vettore di MinHash (100–500); similarità stimata = frazione di posizioni uguali |
| LSH (bande) | bande da righe (); candidata se identica in almeno una banda |
| Probabilità candidata | , curva a S con soglia |
| Bag of Words | Vettore di frequenze delle parole del vocabolario, ignora l’ordine |